Gemelli diversi: i calcolatori 100 e 110 ostacoli di ilCoach
Sep 30, 2026
Due calcolatori per 100 e 110 ostacoli: stessa interfaccia, due motori scientifici differenti
Dieci anni dopo: da occhio, metro e cronometro ai modelli predittivi
Una decina di anni fa, nell'articolo di ilCoach sugli ostacoli intitolato «Ostacoli: occhio, metro e cronometro», avevamo reso pubbliche alcune tabelle che permettevano agli allenatori di orientarsi rispetto ai tempi rilevati ai propri atleti. L'idea era semplice: prendere un cronometro, misurare alcuni passaggi e avere almeno un riferimento con cui confrontarli. Quelle tabelle non pretendevano di spiegare tutta la gara, ma davano un ordine ai numeri e rendevano più utile ciò che l'occhio dell'allenatore vedeva in pista.
Oggi possiamo fare un passo molto più lungo. La ricerca scientifica ha messo a disposizione dataset più ampi, analisi temporali più sofisticate e, soprattutto, modelli che non si limitano a dire quali tempi siano mediamente associati a una certa prestazione, ma consentono anche di stimare la prestazione finale a partire da alcuni touchdown realmente osservati. Il cronometro resta lo stesso; ciò che cambia è la quantità di informazione che riusciamo a estrarre da quei centesimi.
È da questa evoluzione che nascono i nuovi Calcolatori 100 m ostacoli e 110 m ostacoli di ilCoach. Non sono soltanto tabelle rese interattive: provano a trasformare la letteratura scientifica disponibile in uno strumento che l'allenatore possa utilizzare mentre analizza una gara. Se questo è il salto compiuto in circa dieci anni, è difficile non chiedersi che cosa saremo in grado di vedere, misurare e prevedere fra altri dieci.
I due calcolatori si assomigliano molto nell'aspetto, ma non sono costruiti allo stesso modo. Per questo li abbiamo chiamati, in questo articolo, gemelli diversi.
Un tempo finale dice quanto, ma non sempre dice come
Dire che un'atleta ha corso i 100 ostacoli in 13.50, oppure che un atleta ha corso i 110 in 13.50, significa conoscere il risultato della gara; non significa però conoscere automaticamente il modo in cui quel risultato è stato costruito. Due prestazioni identiche al centesimo possono nascere da distribuzioni opposte: un atleta può guadagnare nella prima parte e perdere progressivamente negli ultimi ostacoli, mentre un altro può entrare più lentamente nel ritmo, crescere nella parte centrale e arrivare allo stesso crono finale attraverso un percorso diverso.
Il tempo al traguardo mette tutto insieme. I touchdown, invece, permettono di aprire la gara e osservare ciò che è successo al suo interno. Per touchdown intendiamo il tempo cumulativo dal segnale di partenza fino al contatto a terra della gamba d'attacco dopo il superamento di ciascun ostacolo: TD1 è quindi il tempo fino all'atterraggio dopo H1, TD4 quello fino all'atterraggio dopo H4 e così via fino a TD10.
Anche pochi touchdown, se rilevati con sufficiente precisione, possono già raccontare molto. Il problema successivo, però, è inevitabile: con che cosa li confrontiamo? Un passaggio a H4 è veloce o lento soltanto in relazione al livello dell'atleta e alla distribuzione di gara che ci aspettiamo. È qui che entrano in gioco i modelli.
Una mappa che si legge in due direzioni
Un modo semplice per capire la differenza fra i due calcolatori è pensare a una mappa. Il calcolatore dei 100 ostacoli assomiglia a una grande mappa che può essere letta in entrambe le direzioni. Se conosciamo la destinazione, cioè il tempo finale, la mappa ci mostra quale percorso di gara tende a essere associato a quel livello; se invece conosciamo alcuni punti attraverso i quali l'atleta è realmente passato, cioè i touchdown, possiamo cercare sulla stessa mappa quale destinazione sia maggiormente compatibile con quel percorso.
Nel 100 ostacoli, quindi, il mondo di riferimento resta lo stesso: il modello di Kimura. Ci muoviamo all'interno di una struttura statistica unica, andando dal tempo al pattern oppure, nella sezione Analisi atleta, dai touchdown al tempo finale più compatibile con quel pattern.
Il calcolatore dei 110 ostacoli è diverso. Qui non disponiamo di una sola mappa che svolga bene entrambe le funzioni, perciò abbiamo preferito utilizzare due strumenti specializzati: Shibayama per descrivere come tende a distribuirsi la gara a un determinato livello e Iwasaki per stimare quale risultato finale sia compatibile con i touchdown realmente osservati. La destinazione prevista da Iwasaki viene poi riportata sulla mappa descrittiva di Shibayama per rappresentarne il pattern di gara.
Dal gioco elettronico al Game Boy
Se vogliamo spingere la metafora ancora più in là, possiamo pensare ai vecchi giochi elettronici portatili. Il calcolatore dei 100 ostacoli ricorda quei dispositivi nei quali scenario, personaggi e possibilità erano già incorporati nello stesso gioco: tutto accade all'interno di un unico mondo. Kimura fornisce quel mondo, ampio abbastanza da rappresentare livelli prestativi molto diversi; il calcolatore si muove al suo interno, interpolando fra i pattern disponibili.
Il calcolatore dei 110, invece, assomiglia di più a un Game Boy. La console è la stessa, ma la funzione cambia a seconda della cartuccia che inseriamo. Con la cartuccia Shibayama chiediamo: «Descrivimi come tende a essere costruita una gara da 13.50». Con la cartuccia Iwasaki chiediamo: «Ho osservato questi touchdown: a quale prestazione finale sono compatibili?». Una volta ottenuta la previsione, torniamo alla cartuccia descrittiva per vedere come si presenta il pattern corrispondente.
La metafora serve a chiarire un punto metodologico: i due calcolatori non sono stati resi artificialmente identici per comodità di programmazione. Al contrario, abbiamo adattato lo strumento alla letteratura disponibile per ciascuna specialità. Nel 100 un solo modello può svolgere entrambe le funzioni; nel 110 è più corretto far dialogare due modelli diversi, ciascuno usato per ciò che sa fare meglio.
Descrivere e prevedere non sono la stessa cosa
La distinzione più importante per comprendere soprattutto il calcolatore dei 110 ostacoli è quella fra modello descrittivo e modello predittivo. Un modello descrittivo cerca di rispondere alla domanda: «Come tende a essere distribuita una gara di un atleta di questo livello?». Un modello predittivo, invece, parte da osservazioni realmente raccolte e chiede: «A quale prestazione finale sono statisticamente compatibili i touchdown che ho misurato?».
Le due domande sono collegate, ma non coincidono. Nel primo caso conosciamo il tempo finale o il target e vogliamo ricostruire il profilo di gara atteso; nel secondo conosciamo alcuni punti della gara e vogliamo risalire al tempo finale più plausibile. È proprio questa differenza che spiega perché, nei 110, Shibayama e Iwasaki possano produrre valori non perfettamente coincidenti senza che vi sia alcuna contraddizione.
Che cos'è una regressione, in pratica
La parola regressione può sembrare molto più tecnica di quanto sia il concetto che rappresenta. Immaginiamo di avere davanti le 151 prestazioni utilizzate da Iwasaki, Nunome e Nozawa per il loro studio sui 110 ostacoli. Per ciascuna gara conosciamo il risultato finale e i touchdown dal primo al decimo ostacolo.
Prendiamo TD4. Se mettiamo sull'asse orizzontale il tempo finale e sull'asse verticale TD4, ogni gara diventa un punto. Otterremo una nuvola di punti: in generale gli atleti più veloci avranno TD4 più bassi e quelli più lenti TD4 più alti, ma i punti non saranno perfettamente allineati, perché due atleti che corrono entrambi 13.50 possono arrivare a H4 con qualche centesimo di differenza e costruire la prestazione in modo diverso.
La regressione lineare cerca la retta che rappresenta nel modo migliore possibile la relazione fra le due variabili. In forma semplificata possiamo scriverla come «TD previsto = intercetta + coefficiente × tempo finale». Inserendo 13.50, la regressione restituisce quindi il TD4 statisticamente atteso per una prestazione di quel livello nella popolazione studiata.
Questo non significa che per correre 13.50 sia necessario passare esattamente in quel punto. La regressione non è una prescrizione tecnica e non stabilisce una relazione causale: descrive una tendenza statistica. Alcuni atleti da 13.50 saranno un po' più veloci a TD4, altri un po' più lenti. La dispersione dei punti intorno alla retta rappresenta, in termini intuitivi, il rumore che rimane nella relazione.
Il rumore e il valore predittivo
Per capire quanto una regressione sia informativa possiamo osservare, fra gli altri indicatori, R2, il coefficiente di determinazione. Senza entrare nei dettagli matematici, un R2 basso indica che conoscere una variabile lascia ancora molta incertezza sull'altra; avvicinandosi a uno, invece, la relazione diventa molto più stretta e la previsione più precisa. Nel lavoro di Iwasaki le regressioni associate ai diversi touchdown vanno da valori di R2 intorno a 0,53 fino a valori prossimi a 0,98.
La parte più interessante non è però soltanto l'intervallo dei valori: è il fatto che il potere predittivo aumenti procedendo lungo la gara. Più ci avviciniamo a H10, meno risultati finali diversi sono compatibili con il touchdown osservato. Il rumore, quindi, tende a diminuire.
Un metro dopo la partenza e un metro prima del traguardo
Il modo più semplice per capire il concetto è portarlo volutamente all'assurdo. Immaginiamo di voler prevedere il tempo finale osservando un atleta dopo appena un metro dalla partenza. In quel momento sappiamo pochissimo di ciò che accadrà. Potremmo perfino trovarci davanti a un velocista puro, capace di partire fortissimo ma che non ha mai corso gli ostacoli e che, arrivato davanti alla prima barriera, non saprebbe neppure che cosa fare.
Nella corsia accanto potrebbe esserci invece un ostacolista esperto, con un accredito molto superiore agli avversari della batteria. Sapendo di poter passare il turno agevolmente, potrebbe affrontare la prima parte senza esasperare la partenza, quasi prendendosela comoda. Dopo un metro il primo potrebbe sembrare addirittura più promettente del secondo; eppure quell'osservazione, presa da sola, ci direbbe pochissimo sulla prestazione finale nei 110 ostacoli.
Spostiamoci ora a un metro dal traguardo. Se i due atleti arrivano nello stesso punto nello stesso momento, quasi tutta la gara è ormai alle spalle e manca soltanto un metro. Il ventaglio dei possibili risultati finali si restringe drasticamente. Al traguardo stesso raggiungiamo il caso limite: non stiamo più prevedendo la prestazione, perché la conosciamo.
I touchdown seguono lo stesso principio. Un TD1 compatibile con 13.50 significa che l'atleta ha iniziato la gara in un modo compatibile con quella prestazione, ma davanti a lui restano nove ostacoli e quasi tutta la prova. Un TD7 compatibile con 13.50 contiene molta più informazione, perché una parte importante della gara è già stata costruita; un TD10 compatibile con 13.50 lascia invece soltanto il run-in e restringe enormemente il ventaglio dei risultati possibili.
È utile precisare che questo non significa necessariamente che il nostro algoritmo assegni un peso matematico maggiore a TD10 rispetto a TD1. Il punto è che la relazione statistica di TD10 con il risultato finale è molto più stretta e, di conseguenza, quel dato possiede un potere predittivo superiore. A un metro dalla partenza esistono ancora moltissime gare possibili; a un metro dal traguardo ne esistono pochissime.
Perché H7 e H10 raccontano così tanto
Questo progressivo restringimento dell'incertezza dà una base quantitativa a un'impressione molto familiare a chi osserva molte gare di ostacoli. Un passaggio eccellente a H1 è interessante, ma non garantisce quasi nulla sul risultato finale. Arrivare invece a H7 perfettamente dentro il ritmo di una grande prestazione significa aver già costruito una quota importante della gara; se la compatibilità rimane alta anche a H10, diventa statisticamente difficile che il crono finale sia molto lontano da ciò che quei cumulativi stanno indicando.
Naturalmente non significa che dopo H7 sia impossibile sbagliare. Si può urtare una barriera, perdere assetto, commettere un errore tecnico importante o uscire male da H10. Significa però che, procedendo verso la fine, diminuisce la quantità di gara che deve ancora accadere e quindi anche la possibilità che il risultato si allontani molto da quello suggerito dai passaggi già realizzati. È proprio questa riduzione del rumore che rende TD7 e soprattutto TD10 così informativi.
I due motori dei 110 ostacoli
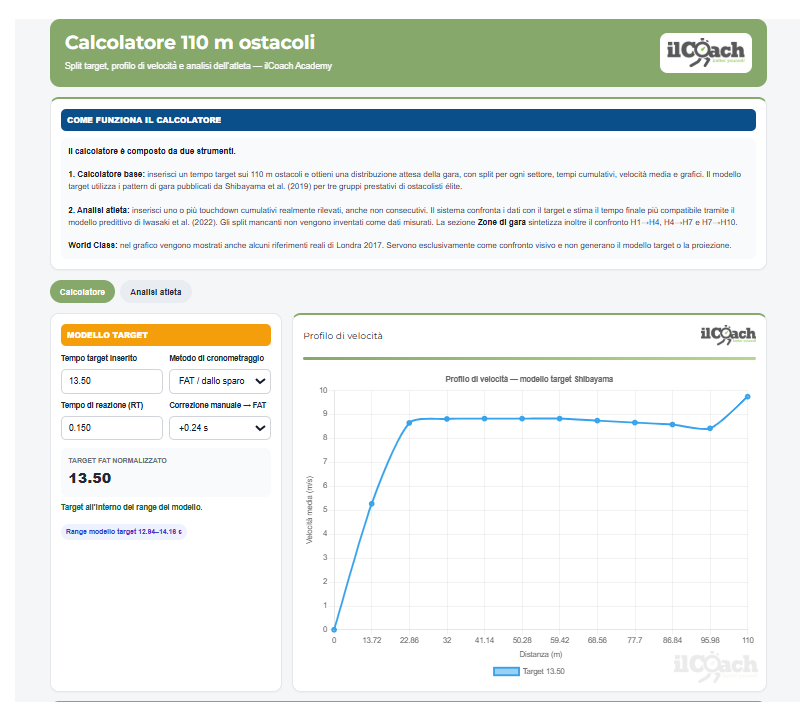
A questo punto il funzionamento del Calcolatore 110 m ostacoli diventa più facile da leggere. Dietro la stessa interfaccia lavorano due modelli distinti: Shibayama et al. (2019) viene utilizzato soprattutto per descrivere il pattern della gara, mentre Iwasaki, Nunome e Nozawa (2022) viene utilizzato per stimare la prestazione compatibile con i touchdown realmente osservati. In altre parole, una cartuccia descrive la strada e l'altra cerca di prevedere la destinazione.
Shibayama: come tende a essere costruita una gara di questo livello?
Shibayama e colleghi hanno analizzato 76 ostacolisti maschi di alto livello, suddividendo le prestazioni in tre gruppi: 12.94-13.38, 13.40-13.68 e 13.70-14.16. Le gare sono state studiate con video ad alta frequenza e il lavoro descrive come cambiano gli intervalli e la distribuzione della prestazione fra i diversi livelli.
Nel nostro calcolatore i valori medi dei gruppi vengono normalizzati e interpolati. Se inseriamo, per esempio, un target di 13.50, il sistema costruisce un pattern rappresentativo di una prestazione di quel livello sulla base della struttura descritta da Shibayama, restituendo approach, intervalli, cumulativi e velocità medie.
Questi valori sono un benchmark, non una prescrizione. Non stiamo affermando che ogni atleta che vuole correre 13.50 debba passare esattamente in quei tempi; stiamo dicendo che, nella popolazione studiata, una prestazione di quel livello tende ad avere quella distribuzione. Per rispettare i limiti dei dati, il modello target viene utilizzato nel range 12.94-14.16, senza prolungarlo artificialmente molto oltre la popolazione osservata.
Iwasaki: dai touchdown alla prestazione
Quando passiamo alla sezione Analisi atleta la domanda cambia. Non chiediamo più come dovrebbe essere distribuito un 13.50, ma quale prestazione finale sia maggiormente compatibile con i touchdown realmente raccolti. È qui che entra Iwasaki.
Lo studio utilizza 151 prestazioni, con un range approssimativo da 12.91 a 14.47 secondi, e costruisce una regressione specifica per ciascun touchdown: TD1-tempo finale, TD2-tempo finale e così via fino a TD10. Gli autori verificano inoltre la capacità di generalizzazione del modello attraverso una procedura di leave-one-out cross-validation, controllando ripetutamente come si comporta la previsione quando una singola osservazione viene lasciata fuori dalla costruzione della regressione.
Quando inseriamo più touchdown, il calcolatore cerca quindi il tempo finale che rende complessivamente più compatibili i valori osservati con le relazioni descritte da Iwasaki. Il risultato non è una certezza, ma la prestazione che meglio si accorda con quei passaggi all'interno della popolazione studiata.
Un esempio pratico: target 13.50, proiezione 13.46
Usiamo valori inventati a scopo didattico, non i coefficienti reali dello studio. Immaginiamo di avere rilevato quattro touchdown:
| Touchdown | Atleta |
|---|---|
| TD1 | 2.50 |
| TD4 | 5.82 |
| TD7 | 9.08 |
| TD10 | 12.39 |
Supponiamo che, considerate separatamente, le diverse regressioni rendano TD1 particolarmente compatibile con circa 13.40, TD4 con 13.44, TD7 con 13.46 e TD10 con 13.47. Il sistema non si limita a fare la media aritmetica di questi quattro numeri: cerca la prestazione che produce il miglior adattamento complessivo ai touchdown inseriti e potrebbe, per esempio, restituire una proiezione di 13.46.
La formulazione corretta sarebbe quindi: «La combinazione dei touchdown osservati è statisticamente maggiormente compatibile con una prestazione di circa 13.46 nella popolazione su cui è stato costruito il modello». Non significa che l'atleta correrà certamente 13.46, ma che quei passaggi, considerati insieme, assomigliano più a una gara di quel livello che a una da 13.30 o 13.70.
Perché descrittivo e predittivo possono dare numeri diversi
Supponiamo che il target impostato dall'allenatore sia 13.50. Shibayama descrive il pattern rappresentativo di un 13.50; i touchdown realmente registrati, però, potrebbero portare Iwasaki a stimare 13.42 oppure 13.61. Non c'è alcuna contraddizione, perché i due numeri rispondono a domande differenti: il primo dice come tende a distribuirsi una gara da 13.50, il secondo dice a quale prestazione sono maggiormente compatibili i dati prodotti da quello specifico atleta.
Perfino quando il tempo finale coincide, i valori dei due modelli non devono necessariamente essere identici al centesimo. Un TD4 atteso da Shibayama per 13.50 potrebbe essere leggermente diverso dal TD4 previsto dalla regressione di Iwasaki per lo stesso tempo finale. I due studi hanno campioni, numerosità, finalità e procedure statistiche differenti; è quindi perfettamente possibile che descrivano lo stesso livello prestativo con valori lievemente diversi senza che uno dei due sia, per questo, sbagliato.
Esempio puramente illustrativo, con numeri inventati per mostrare il concetto:
| Touchdown | Shibayama: pattern descrittivo 13.50 | Iwasaki: valore atteso per 13.50 |
|---|---|---|
| TD1 | 2.55 | 2.58 |
| TD4 | 5.90 | 5.86 |
| TD7 | 9.15 | 9.12 |
| TD10 | 12.40 | 12.42 |
Perché non sottraiamo semplicemente le regressioni di Iwasaki
Potremmo essere tentati di utilizzare le regressioni cumulative di Iwasaki per ricavare direttamente ogni intervallo, sottraendo, per esempio, TD3 previsto da TD4 previsto. Matematicamente l'operazione è possibile, ma metodologicamente è meno pulita, perché TD3 e TD4 sono il risultato di due regressioni costruite indipendentemente e lo studio non ha modellizzato direttamente lo split H3-H4.
Per questo, una volta che Iwasaki ha individuato il tempo finale più compatibile con i touchdown osservati, il nostro calcolatore torna al modello descrittivo di Shibayama per rappresentare il pattern corrispondente a quel livello prestativo. La sequenza è dunque: touchdown osservati → regressioni di Iwasaki → tempo finale stimato → pattern Shibayama. Il modello predittivo viene utilizzato per prevedere e quello descrittivo per descrivere, senza chiedere a nessuno dei due di fare ciò per cui non è stato costruito.
Che cosa ci dice l'RMSE
Nel riepilogo della proiezione compare anche l'RMSE, acronimo di Root Mean Square Error, cioè radice dell'errore quadratico medio. Serve a sintetizzare quanto i touchdown osservati siano distanti dai valori previsti dal modello per la soluzione individuata. Gli errori sui diversi punti vengono elevati al quadrato, mediati e infine riportati, tramite radice quadrata, nella stessa unità di misura dei dati: i secondi.
Se, per esempio, gli scarti sui quattro touchdown fossero +0.02, -0.03, +0.01 e +0.04 secondi, l'RMSE sarebbe dell'ordine di pochi centesimi. Più il valore è vicino a zero, migliore è l'adattamento complessivo fra i touchdown osservati e quelli attesi dal modello.
Va però evitata un'interpretazione comune: RMSE basso non significa atleta migliore. Un atleta da 14.00 può avere un RMSE molto basso perché distribuisce la gara in modo estremamente simile al pattern statistico del proprio livello; un atleta da 13.20 può avere un RMSE più alto perché possiede una distribuzione molto individuale. L'RMSE misura quindi soprattutto la compatibilità con il modello, non il valore assoluto della prestazione. Per lo stesso motivo non abbiamo attribuito etichette arbitrarie come «ottimo», «buono» o «scarso» a intervalli di RMSE che non siano stati validati in modo specifico.
Nei 100 ostacoli il motore è più unitario
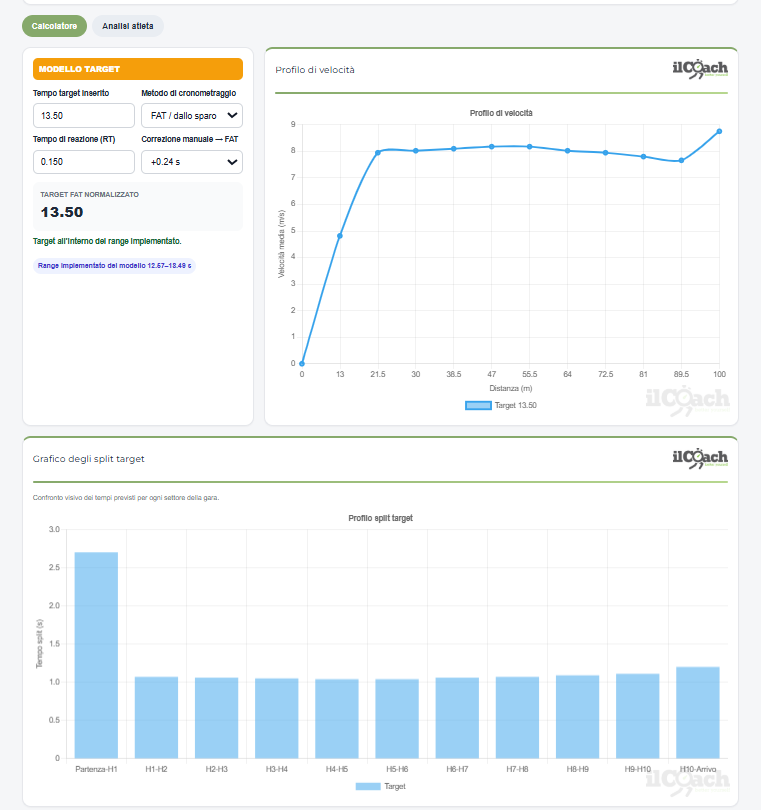
Il Calcolatore 100 m ostacoli segue una logica diversa. Il riferimento principale è il lavoro di Kimura et al. (2026), dedicato alle caratteristiche temporali dei 100 ostacoli lungo livelli prestativi molto differenti. È proprio l'ampiezza del campione prestativo a rendere lo studio particolarmente interessante per l'allenatore, perché consente di osservare non soltanto quanto cambiano i tempi, ma anche come può cambiare la forma della gara passando dal livello mondiale a livelli molto più bassi.
Il punto metodologico è importante: le atlete meno veloci non percorrono necessariamente la stessa gara delle migliori con tutti gli split semplicemente allungati nella stessa proporzione. Il momento in cui viene raggiunto il massimo ritmo e il modo in cui la velocità viene mantenuta o persa possono modificarsi con il livello prestativo. Prendere il pattern di una 12.50 e scalarlo linearmente per descrivere una 16.50 sarebbe quindi una semplificazione eccessiva.
Nel nostro calcolatore i pattern medi di Kimura vengono normalizzati e interpolati fra ancoraggi compresi tra 12.57 e 18.49 secondi. Se inseriamo un target di 14.20, il sistema costruisce il profilo compatibile con quel livello senza limitarsi a moltiplicare gli split per una costante. Nella sezione Analisi atleta, invece, i touchdown realmente rilevati vengono confrontati con i pattern possibili per individuare il tempo finale che produce il miglior adattamento.
Nel 100 ostacoli, dunque, lo stesso universo statistico lavora sostanzialmente nelle due direzioni: dal tempo finale al pattern atteso e dai touchdown osservati al tempo finale maggiormente compatibile. È la mappa bidirezionale di cui parlavamo all'inizio.
Gemelli diversi, in una tabella
| 100 m ostacoli | 110 m ostacoli | |
|---|---|---|
| Modello descrittivo | Kimura et al. (2026) | Shibayama et al. (2019) |
| Modello predittivo | Kimura, tramite miglior adattamento al pattern | Iwasaki et al. (2022), regressioni TD-tempo finale |
| Metafora | Una mappa letta in entrambe le direzioni | Una console con due cartucce specializzate |
| Logica | Un unico universo statistico | Due modelli con funzioni distinte |
| Range implementato | 12.57-18.49 | Target 12.94-14.16; previsione 12.91-14.47 |
| Punto di forza | Ampiezza dei livelli e variazione del pattern | Separazione fra descrizione della gara e previsione dai touchdown |
Un calcolatore non è un allenatore
I due strumenti devono essere letti come termini di confronto, non come prescrizioni. Un pattern medio non è necessariamente il pattern ideale per ogni individuo: antropometria, capacità di accelerazione, qualità tecniche, rapporto fra velocità e abilità di valicamento, caratteristiche di forza e capacità di conservare il ritmo possono produrre soluzioni differenti allo stesso compito.
Se un atleta da 13.50 presenta sistematicamente un pattern diverso dal modello ma continua a produrre prestazioni di alto livello, il compito dell'allenatore non è costringerlo ad assomigliare alla media; è capire perché se ne discosta e se quella differenza rappresenti un limite, una caratteristica individuale o persino un punto di forza. In questo senso il calcolatore non dà risposte definitive: serve soprattutto a generare domande migliori.
Anche per questo l'Analyzer non richiede necessariamente dieci touchdown. È possibile inserire soltanto i punti realmente misurati, per esempio H1, H4, H7 e H10, senza inventare dati negli ostacoli mancanti. La stima del modello resta distinta dalla misurazione reale, permettendo di utilizzare lo strumento anche con analisi video semplici o con rilevamenti effettuati direttamente in pista.
Le tre zone come linguaggio operativo
Per rendere la lettura più immediata, entrambi i calcolatori sintetizzano la parte centrale della gara in tre zone: H1-H4, H4-H7 e H7-H10, denominate rispettivamente Accelerazione, Max Rhythm e Rhythm Endurance. Non devono essere confuse con fasi fisiologiche rigide o con una suddivisione universale della specialità: sono una sintesi operativa pensata per permettere all'allenatore di vedere rapidamente dove l'atleta costruisce o perde tempo rispetto al riferimento.
H1-H4 descrive la fase in cui, dopo l'ingresso sul primo ostacolo, viene costruito e stabilizzato il ritmo; H4-H7 rappresenta la parte centrale, generalmente più vicina al massimo ritmo sostenibile; H7-H10 permette di osservare la capacità di conservare efficacia e velocità negli ultimi ostacoli. Il tratto H10-arrivo resta separato perché ha caratteristiche proprie: uscita dall'ultima barriera e sprint finale.
Alla luce delle regressioni di Iwasaki, la scelta di osservare in particolare H7 e H10 assume anche un significato ulteriore. A H7 il risultato finale ha già cominciato a prendere una forma molto definita; a H10 ne resta aperta soltanto una piccola parte. Il dato non sostituisce l'occhio dell'allenatore, ma gli dà una misura quantitativa della quantità di gara già costruita.
Lo stesso 13.52 può raccontare due gare opposte
Immaginiamo due atleti con target 13.50 che terminano entrambi in 13.52. Guardando soltanto il risultato finale potremmo concludere che hanno mancato il target di due centesimi. L'analisi per zone può però raccontare storie completamente differenti.
| Zona | Caso A | Caso B |
|---|---|---|
| H1-H4 | +0.08 | -0.06 |
| H4-H7 | -0.05 | -0.02 |
| H7-H10 | -0.03 | +0.10 |
Nel Caso A l'atleta entra lentamente nella gara e recupera progressivamente; nel Caso B costruisce un vantaggio iniziale ma lo perde negli ultimi ostacoli. Il cronometro finale è quasi identico, mentre le indicazioni per il lavoro tecnico possono essere molto diverse. È precisamente questo il passaggio che ci interessa: non soltanto sapere quanto è stato corso, ma capire come quel tempo è nato.
I limiti contano quanto le possibilità
Un modello statistico è utile soltanto se vengono rispettati anche i suoi confini. Il modello dei 100 ostacoli viene utilizzato nel range implementato 12.57-18.49; il target Shibayama dei 110 nel range 12.94-14.16; il modello predittivo Iwasaki nel range 12.91-14.47. Uscire molto oltre questi intervalli significherebbe chiedere ai modelli di descrivere popolazioni che non hanno realmente osservato.
Inoltre, una regressione non può incorporare automaticamente tutto ciò che può succedere in gara. Vento, urti con gli ostacoli, errori tecnici importanti, condizioni della pista, strategia individuale e caratteristiche specifiche dell'atleta possono spostare una prestazione rispetto al valore atteso. Il risultato del calcolatore va quindi trattato come una stima informata, non come un verdetto.
Lo strumento non sostituisce l'osservazione; la rende più ricca. L'idea è usare la ricerca per migliorare le domande che facciamo alla prestazione, non per cancellare il ruolo dell'allenatore.
Dal paper alla pista, e poi?
La ricerca applicata all'atletica sta diventando sempre più ricca, ma leggere un articolo scientifico e riuscire a utilizzarlo in pista sono due passaggi differenti. Un allenatore difficilmente arriva all'allenamento pensando di applicare una regressione lineare validata con leave-one-out cross-validation; può però filmare una gara, rilevare quattro touchdown, inserirli in un calcolatore e vedere immediatamente dove l'atleta guadagna o perde rispetto a un target e quale prestazione è compatibile con quei passaggi.
È questo il senso dei due strumenti: non sostituire l'allenatore con un algoritmo, ma mettere un algoritmo, costruito sulla letteratura disponibile, nelle mani dell'allenatore. Dieci anni fa avevamo soprattutto occhio, metro, cronometro e tabelle. Oggi possiamo aggiungere modelli descrittivi e predittivi. Fra altri dieci anni, probabilmente, avremo strumenti capaci di integrare automaticamente video, biomeccanica, velocità istantanee e dati individuali. Non sappiamo ancora dove arriveremo; sappiamo però che il percorso è già cominciato.
Proprietà intellettuale e condizioni di utilizzo
I Calcolatori 100 m ostacoli e 110 m ostacoli ilCoach sono messi gratuitamente a disposizione di allenatori, atleti, studenti, ricercatori e appassionati. La gratuità dell'accesso, tuttavia, non equivale alla rinuncia ai diritti sulle componenti originali del software.
Nel diritto italiano ed europeo i programmi per elaboratore possono essere protetti dal diritto d'autore quando costituiscono creazioni originali. La tutela riguarda l'espressione del programma, per esempio il codice e gli elementi creativi originali della sua realizzazione, ma non attribuisce un monopolio sulle idee, sui principi, sulle formule matematiche o sugli algoritmi scientifici sottostanti.
Questa distinzione è particolarmente importante nel nostro caso. Kimura, Shibayama, Iwasaki e gli altri lavori utilizzati come fonti scientifiche non appartengono a ilCoach e devono continuare a essere attribuiti ai rispettivi autori. Un altro soggetto può studiare gli stessi articoli e sviluppare autonomamente un proprio strumento. Ciò che ilCoach può invece tutelare, nei limiti previsti dalla normativa, è la propria specifica realizzazione: codice originale, testi, struttura dell'Analyzer, organizzazione dei contenuti, soluzioni implementative ed eventuali elementi creativi dell'interfaccia.
Per disciplinare anche l'uso del servizio e dei risultati generati è opportuno affiancare alla tutela automatica del diritto d'autore una licenza o condizioni d'uso chiaramente visibili. Se si vuole consentire liberamente l'uso tecnico e didattico dei calcolatori ma richiedere la citazione della fonte nelle pubblicazioni, è preferibile formulare questa richiesta espressamente e renderla facilmente accessibile dalla pagina dello strumento. Per una versione destinata a produrre effetti contrattuali, il testo definitivo dovrebbe essere verificato da un professionista legale.
Condizioni d'uso proposte
L'utilizzo online dei calcolatori ilCoach è consentito per finalità personali, tecniche, didattiche, di allenamento e di ricerca.
In caso di utilizzo di risultati, tabelle, grafici, screenshot o altre elaborazioni generate dai calcolatori in articoli, pubblicazioni scientifiche, tesi, libri, presentazioni, corsi, dispense, contenuti online, social media o materiali didattici, si richiede di indicare la fonte «ilCoach.net - Calcolatore 100 m ostacoli» oppure «ilCoach.net - Calcolatore 110 m ostacoli», inserendo il collegamento alla pagina originale quando il mezzo lo consente. Quando vengono richiamati i modelli scientifici sottostanti, devono inoltre essere citati i rispettivi studi originali.
Senza preventiva autorizzazione scritta di ilCoach.net ASD non è consentito copiare o ripubblicare il codice del calcolatore, riprodurre integralmente il software su un altro sito o piattaforma, distribuire copie del programma, pubblicare versioni modificate del codice originale, effettuare mirroring dello strumento, incorporarlo in altri siti mediante iframe o sistemi equivalenti in modo da presentarlo come parte di un servizio terzo, né rimuovere o occultare le indicazioni di paternità e provenienza presenti nello strumento.
È invece consentito linkare liberamente le pagine originali dei calcolatori ilCoach.
L'obiettivo di queste condizioni non è limitare la circolazione dello strumento, ma rendere compatibili due esigenze: permetterne un uso ampio da parte di allenatori, studenti e ricercatori e, nello stesso tempo, riconoscere il lavoro necessario per trasformare la letteratura scientifica in uno strumento utilizzabile. In sintesi: la ricerca va citata e anche il lavoro di implementazione va correttamente attribuito.
© 2026 ilCoach.net ASD - Tutti i diritti riservati.
Nota: questa sezione ha finalità informativa generale e non sostituisce una consulenza legale. Per adottare condizioni d'uso con valore contrattuale o valutare ulteriori forme di tutela del software è consigliabile una verifica professionale.
Ti è stato utile questo articolo?
ilCoach.net è un'ASD e il lavoro di ricerca, scrittura e approfondimento che sta dietro a questi contenuti è possibile anche grazie al supporto della nostra community.
Se vuoi aiutarci a continuare a produrre articoli, analisi e materiali di qualità, puoi sostenerci in modo concreto tesserandoti alla nostra ASD.
Scopri il tesseramento →Riferimenti principali
Kimura K., Sato K., Miyauchi I., Hase S., Kakehata G., Goto Y., Iso S. (2026). Temporal characteristics of 100-m hurdles performance based on race analysis - ranging 12-18 s. Scientific Journal of Sport and Performance, 5(2), 347-354. DOI: 10.55860/WMQR1877.
Shibayama K., Kijima K., Morioka Y., Sakurai K. (2019). The relationship between race pattern and performance of elite 110m hurdlers. Japan Journal of Physical Education, Health and Sport Sciences, 64, 475-485. DOI: 10.5432/jjpehss.18120.
Iwasaki R., Nunome H., Nozawa K. (2022). New predictive model of the touchdown times in a high level 110 m hurdles. PLOS ONE, 17(12), e0278651. DOI: 10.1371/journal.pone.0278651.
Per approfondire
- SuperCecco e il quinto ostacolo — lo stesso studio di Kimura applicato a un caso pratico: perché la gara delle ostacoliste migliori si costruisce dal quarto-quinto ostacolo in avanti.
- Ostacoli: occhio, metro e cronometro! — le tabelle di riferimento per i parziali al touchdown nei 100, 110 e 400 ostacoli, il punto di partenza da cui nascono questi calcolatori.
ISCRIVITI ALLA NOSTRA NEWSLETTER!
Iscriviti alla nostra newsletter per restare aggiornato sui nostri contenuti.
Non riceverai SPAM!
"Dichiaro di aver letto l'informativa sulla privacy e acconsento al trattamento dei miei dati personali ai sensi dell’art. 13 D. Lgs. 30 giugno 2003, n.